 DIGITAL
Integração de sistemas sem drama: eventos, APIs e observabilidade para operações que não podem parar
Uma integração que falha no dia de pico não é um bug: é um design de risco. Este guia prático mostra como escolher padrões de integração — eventos, APIs síncronas, mensageria — e que observabilidade implantar para que uma falha em um fornecedor não derrube a operação.
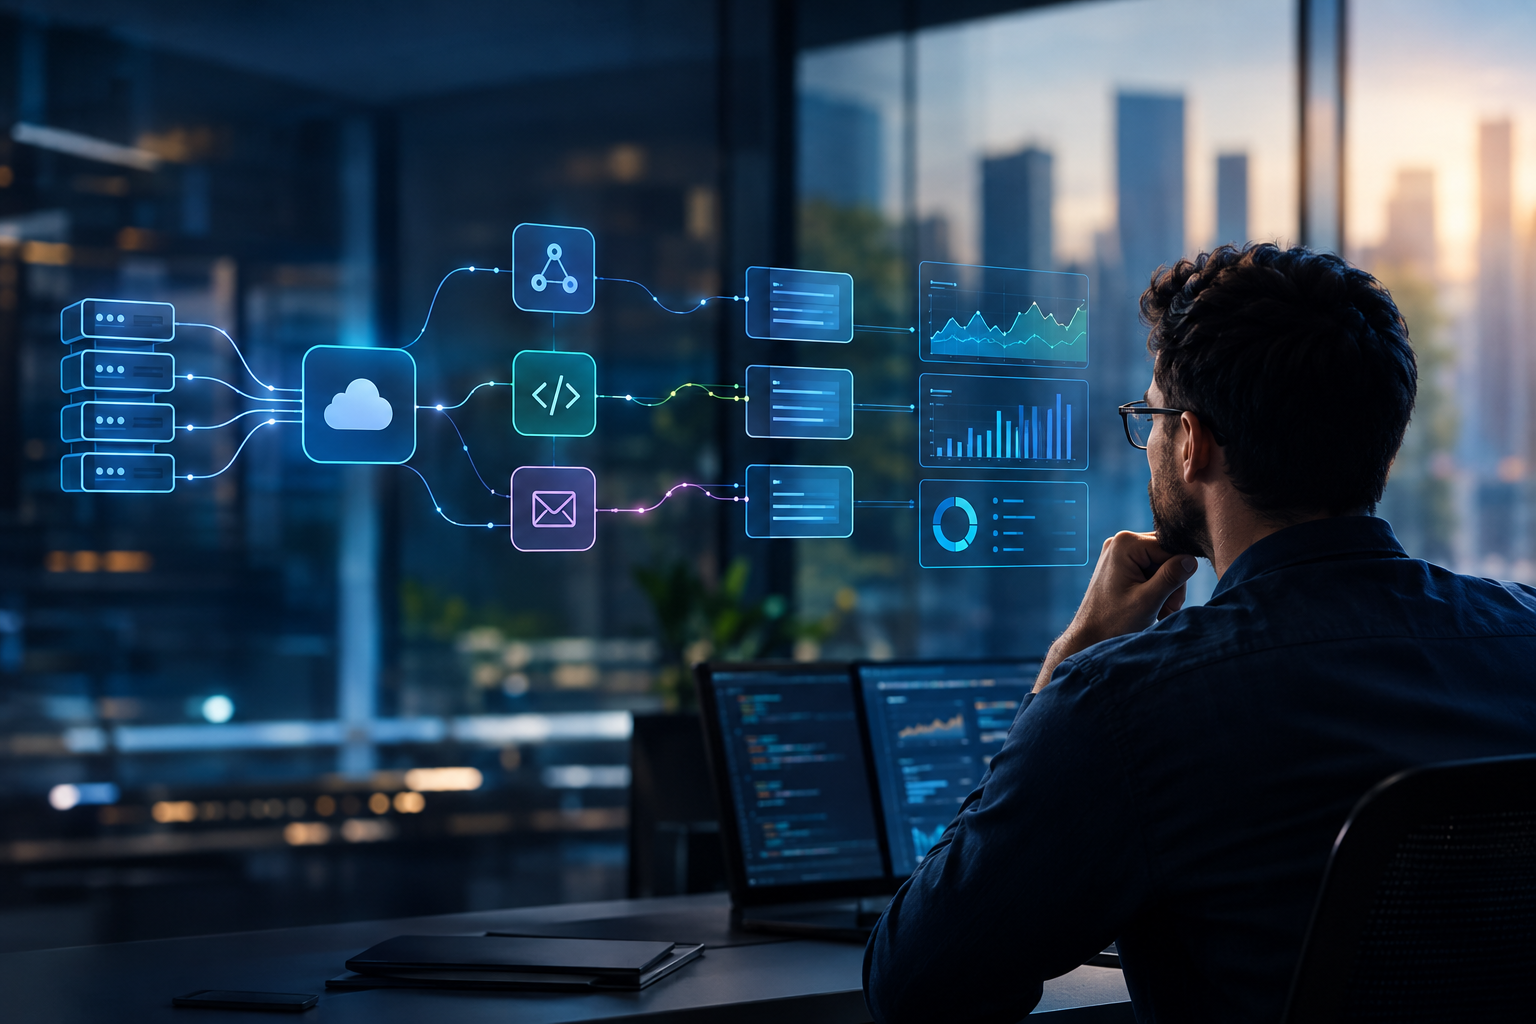
No fechamento do mês, o time de faturamento vê filas crescentes no ERP, o site mostra inconsistências de estoque e o atendimento recebe chamados sobre cobranças duplicadas. Quando uma integração falha no dia de pico, o problema não é apenas um erro técnico: é risco operacional projetado. É urgente mapear onde consistência, latência e tolerância a falhas impactam o negócio e escolher padrões de integração que alinhem risco e serviço.
Este texto oferece um roteiro prático: como decidir entre chamadas API síncronas e eventos assíncronos (mensageria), quais regras aplicar para idempotência e ordenação, que métricas e tracing colocar em produção e como definir SLAs/SLOs para integrações críticas. No fim, descrevo como um assessment técnico com especialistas MVX pode transformar esse diagnóstico em um plano de ação.
Quando preferir mensagem assíncrona a chamada API síncrona?
Decisão operativa: baseie-se no impacto de uma latência ou falha sobre a operação. Prefira mensageria (eventos assíncronos) quando a operação tolera latência eventual e a continuidade do negócio é prioritária — por exemplo, propagação de atualizações de catálogo para canais, enfileiramento de notificações ou processos de contabilização em lote durante fechamento. Prefira API síncrona quando o usuário ou a transação espera resposta imediata e consistente, como autorização de pagamento em checkout.
Risco prático: chamadas síncronas centralizam dependências—se o fornecedor cai, a experiência cai junto. Eventos desacoplam emissores e consumidores, criando buffers naturais; porém exigem políticas claras de retry, compensações e eventual consistência.
Como tratar ordenação e idempotência em sistemas distribuídos?
Ordenação e idempotência são controles mínimos para evitar efeitos colaterais em falhas ou replays. Recomendações práticas:
- Idempotência por chave de negócio: cada operação importante (ex.: pagamento, ajuste de estoque) deve ter uma chave única de deduplicação, armazenada no consumidor para rejeitar replays.
- Ordenação quando importa: use streams particionados por entidade (produto, conta) ou mecanismos de sequência; se a ordem global é essencial, prefira transações coordenadas ou APIs síncronas com locks de curto prazo.
- Compensação para operações irreversíveis: disponibilize processos de compensação (ex.: estorno) e registre eventos de compensação como parte do fluxo para auditoria.
Quais SLAs e SLOs definir para integrações críticas?
Comece definindo o que o negócio não tolera: perda de pedidos, duplicação de cobrança, inconsistência de estoque. Para cada classe de integração, proponha SLOs que reflitam esses limites, por exemplo:
- Disponibilidade logicamente relevante (p.ex. 99.9% uptime para APIs de autorização durante janela de pico) — definir com base em impacto, não em desejo técnico.
- Latência p95/p99 para caminhos síncronos críticos.
- Taxa máxima de perda de eventos aceitável (meta próxima de zero) e tempo máximo de replay/retorno para mensageria.
Não confunda SLA de fornecedor com SLO interno: defina SLOs mensuráveis e monitore em sua camada de integração independente do contrato do fornecedor.
Observabilidade prática: tracing, logs, métricas e alertas que previnem incidentes
Observabilidade é o que salva operações antes que falhas virem crise. Priorize quatro sinais:
- Tracing distribuído para seguir uma transação entre ERP, CRM e plataforma web — identifica latência por hop.
- Logs estruturados com campo de correlação (trace id, request id, business key).
- Métricas de negócio e infra: taxa de erros, latência p95/p99, backlog de filas, taxa de rejeições por idempotência.
- Alertas acionáveis que disparam quando métricas cruzadas indicam degradação (ex.: backlog crescendo + queda de throughput do fornecedor).
Checklist de configuração mínima:
- Instrumentar propagação de trace id entre chamadas HTTP e eventos.
- Exportar métricas de filas e consumidores com labels por tópico/partição.
- Centralizar logs e habilitar busca por correlação.
- Definir runbooks curtos anexados a cada alerta crítico.
Comparação prática: chamada síncrona vs evento assíncrono
- Síncrona (API): resposta imediata, consistência forte no caminho, controle transacional direto, maior risco de cascata em falhas externas.
- Assíncrona (eventos): desacoplamento, resiliência a picos via enfileiramento, complexidade maior em ordenação e consistência, necessidade de replays e compensações.
Escolha por consequência operacional: se um fornecedor fica indisponível por 5 minutos durante pico, qual é o custo de bloquear o checkout versus aceitar atrasos na atualização de estoque?
Framework de decisão: latência aceitável, tolerância a falhas, consistência de dados
Use três perguntas para cada integração:
- Qual é a latência máxima que a operação tolera (imediata, minutos, horas)?
- Se a integração falhar, qual é o dano (perda de receita, quebra de compliance, experiência degradada)?
- Qual grau de consistência é necessário (forte, eventual, compensável)?
Mapeie respostas em uma matriz simples: latência imediata + dano alto + consistência forte => API síncrona com retries curtos e fallback; latência tolerável + dano moderado + consistência eventual => mensageria com retry exponencial e dead-letter queue.
Testes e deploy: contratos, gradualidade e mocks
Práticas que reduzem risco no deploy:
- Contratos versionados e testes de contrato automatizados entre produtores e consumidores.
- Deploy canary para integrações críticas; monitorar métricas de negócio antes de promover rollout completo.
- Mocks de fornecedores com simulação de latência e erros para validar comportamento de retry e compensação.
Inclua testes de caos em ambiente controlado para validar que falhas em fornecedores não rompem a operação.
Trade-offs e limites: latência vs consistência, custo vs complexidade
Não existe solução sem custo. Mensageria reduz risco de cascata, mas aumenta complexidade operacional: é preciso lidar com armazenamento de eventos, retenção, reprocessamento e observabilidade. APIs síncronas simplificam o fluxo mental, mas transferem risco de indisponibilidade para a borda. Escolhas devem refletir custo de manutenção, não apenas preferência tecnológica.
Como evoluir integrações legadas?
Critérios para decidir modernização incremental:
- Impacto atual em operação durante picos.
- Complexidade de desligamento do caminho antigo.
- Benefício medido de desacoplamento (redução de incidentes, tempo médio de recuperação).
Estratégia pragmática: introduza eventos paralelos a uma API existente (dual-write controlado), monitore divergências e migre consumidores gradualmente.
Perguntas frequentes
O que é melhor para sincronizar dados: eventos ou chamadas API?
Depende do requisito operacional. Se você precisa de resposta imediata e consistência forte, API síncrona; se prioriza resiliência a falhas e desacoplamento, eventos. Combine ambos quando necessário: APIs para caminhos críticos, eventos para replicação eventual e integração assíncrona.
Como garantir que um evento não seja perdido?
Use confirmações persistentes no broker e estratégias de retry + dead-letter que permitam replay. Implemente idempotência no consumidor e retenção de eventos para reprocessamento. Esses pontos devem constar no contrato entre equipes.
Qual é o papel do broker de mensagens na observabilidade?
O broker fornece métricas essenciais (backlog, throughput por tópico, latência de enfileiramento). Combine essas métricas com tracing e logs para localizar gargalos entre produtor e consumidor.
Checklist rápido antes do rollout
- Mapeamento de dependências e fluxo end-to-end com trace id.
- Tickets de contrato entre equipes e testes automatizados de contrato.
- Métricas instrumentadas e alertas definidos com runbooks anexos.
- Plano de rollback e mocks que simulem falhas do fornecedor.
Se você busca transformar esse roteiro em um plano técnico detalhado, agende um assessment de integração com especialistas MVX. Podemos mapear suas integrações (ERP, CRM, plataforma web), priorizar riscos e propor um roadmap pragmático. Veja também nossa página de soluções em APIs & Integrações e opções de sustentação em Sustentação & Evolução.
Próximo passo: agende um assessment de integração com a equipe MVX para obter um mapa de risco, critérios de priorização e um plano de mitigação alinhado ao negócio.