 DIGITAL
Cómo diseñar una app con IA generativa sin perder el control: arquitectura, límites y gobernanza
Prometer respuestas automáticas es sencillo; mantener control sobre resultados, coste y cumplimiento en el día a día de la app es el reto. Esta guía devuelve una hoja de ruta práctica para decidir, diseñar y operar funciones de IA con criterios para PoC y producción.
Un asistente interno que, por error, modifica campos sensibles en registros operativos es la crisis matutina que nadie desea. Prometer respuestas automáticas es fácil; asegurar que la IA no introduzca incoherencias, costes inesperados o riesgos de cumplimiento es el trabajo real. Tesis central: la IA generativa es una utilidad condicional — muy útil para asistencia, clasificación y borradores, peligrosa cuando recibe autonomía sobre cambios críticos. La arquitectura, los límites operativos y la gobernanza de prompts determinan si la IA ayuda o se convierte en problema.
Qué casos de uso de IA generan ROI operativo y cuáles evitar
Empiece priorizando escenarios con impacto medible y superficie de riesgo controlable. Tres escenarios habituales en apps corporativas ayudan a decidir:
Asistente interno que sugiere acciones (alto beneficio, riesgo moderado)
Descripción: agente que propone textos, guiones de atención o acciones, pero exige aprobación humana antes de ejecutar cambios. Por qué funciona: reduce trabajo repetitivo y acelera procesos. Límite esencial: no permitir acciones automáticas sobre datos sensibles sin autorización.
Enriquecimiento de datos y clasificación (alto beneficio, bajo riesgo)
Descripción: usar IA para extraer entidades, generar metadatos y clasificar registros para mejorar búsqueda y enrutamiento. Por qué funciona: mejora la eficiencia sin alterar sistemas transaccionales. Límite: validar muestras y mantener registros de procedencia de las inferencias.
Búsqueda contextual con embeddings (beneficio situacional, riesgo de privacidad y coste)
Descripción: combinar vectores semánticos con un generador para respuestas contextuales. Por qué funciona: convierte grandes bases en respuestas útiles. Límite: controlar qué datos se indexan, derechos de uso y frecuencia de actualización de vectores.
Cuándo elegir modelos on-device frente a APIs en la nube
La elección entre local y nube tiene trade-offs claros. Use estas reglas prácticas:
- On-device u on-premise: elegir cuando la latencia local y la preservación de datos sensibles son críticas, o cuando políticas impiden enviar datos a terceros. Límite: mantenimiento, necesidad de actualizaciones y coste de hardware.
- APIs en la nube: elegir cuando se necesita modelos actualizados, escalabilidad elástica e integración rápida. Límite: exposición de datos a proveedores y costes por llamada; mitigación mediante anonimización y contratos.
- Híbrido: embeddings locales con generación en la nube, o inferencia local para pasos deterministas y nube para creatividad. Este patrón equilibra control y capacidad.
Arquitectura práctica: flujos de datos y patrones de integración
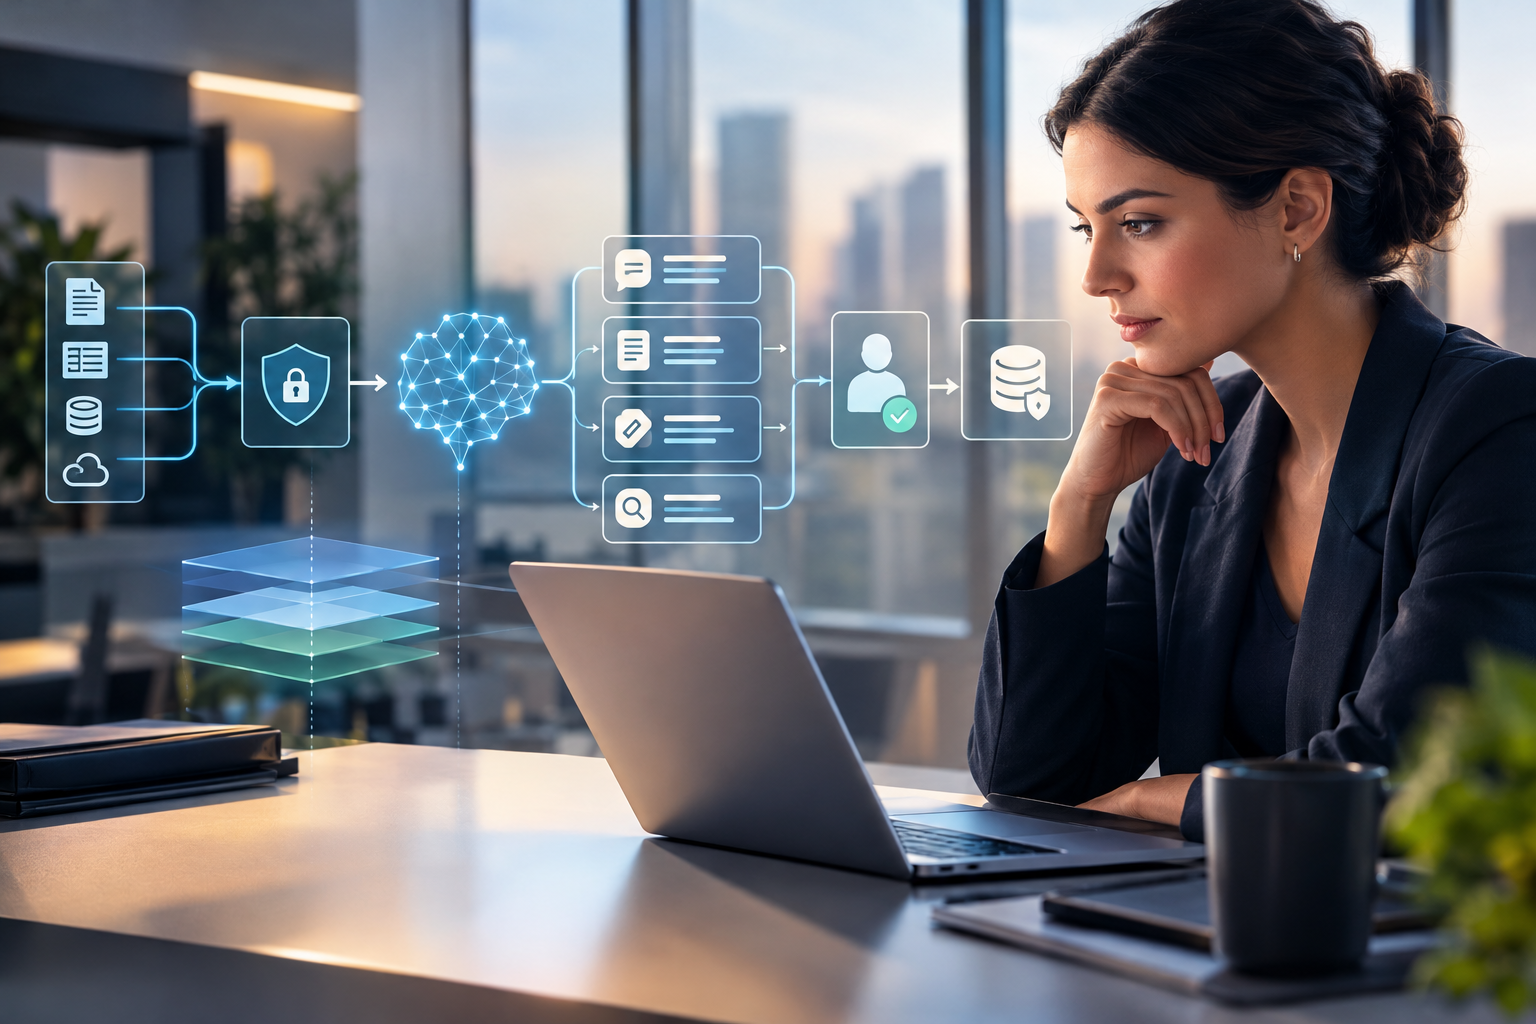
Arquitectura mínima recomendada para una app corporativa con IA generativa:
- Ingesta y preprocesamiento: normalización y anonimización antes de cualquier envío externo.
- Capa de embeddings y vector DB: alojada localmente o en entorno controlado para proteger IP; usada para búsqueda contextual.
- Orquestador de prompts: servicio que aplica plantillas, límites de tokens y políticas antes de invocar modelos.
- Capa de inferencia: API de terceros o motor local; responde al orquestador y devuelve borradores o acciones sugeridas.
- Validación humana y reglas de bloqueo: verificaciones automáticas y pasos de aprobación con logs y posibilidad de rollback.
- Observabilidad y auditoría: captura de métricas y rastros para cada inferencia, sin almacenar datos sensibles innecesariamente.
Flujo ilustrativo (a modo de ejemplo): usuario solicita resumen → preprocesamiento anonimiza PII → vector DB devuelve pasajes relevantes → orquestador arma el prompt con límites → modelo genera borrador → sistema registra metadatos de la inferencia y presenta sugerencia para revisión humana.
Gobernanza de prompts, pruebas y aprobación humana
La gobernanza debe ser operativa: no bastan las políticas escritas. Implemente reglas accionables que los equipos de producto puedan aplicar:
- Checklist de prompts: plantillas aprobadas, variables permitidas y filtros negativos. Cada prompt versionado con metadatos de autor y fecha.
- Entorno controlado de pruebas: A/B con tráfico limitado y alcance reducido antes del despliegue.
- Gate humano por categoría: acciones que modifican datos sensibles requieren aprobación explícita o modo solo-sugerencia.
- Política de datos: definir qué campos pueden salir del entorno y cuándo usar hashing, truncamiento o anonimización.
- Proceso de revisión periódica: validación manual de muestras y recalibración de prompts ante errores recurrentes.
Checklist rápido de gobernanza de prompts
- Existencia de plantillas aprobadas y versionadas.
- Límites de contexto y tokens definidos.
- Validación humana para alteraciones críticas.
- Registro de inputs/outputs con metadatos para auditoría.
- Procedimiento de anonimización antes de envío externo.
Observabilidad y métricas operacionales esenciales
Defina métricas que permitan decisiones claras. Priorice:
- Latencia por llamada: monitorear distribuciones y picos que impactan la experiencia.
- Coste por llamada: entender el impacto financiero por jornada de usuario.
- Tasa de fallback: porcentaje de veces que la IA no responde y se recurre a ruta alternativa o humano.
- Tasa de override humano: cuando revisores modifican la sugerencia; señal de precisión práctica.
- Tasa de generación insegura: eventos donde la salida viola políticas. Debe generar alertas automáticas.
Instrumente logs con metadatos (versión del prompt, origen del contexto, id del revisor) y retenga solo lo necesario para auditoría, respetando políticas de privacidad.
Plan de PoC y criterios de éxito accionables
Un PoC eficaz tiene alcance reducido, criterios medibles y límites claros. Estructúrelo así:
- Objetivo sucinto: por ejemplo, reducir tiempo medio de revisión en un flujo específico sin permitir escrituras automáticas.
- Alcance técnico: fuentes de datos, si habrá embeddings locales, qué modelo se orquestará y si habrá integración con APIs. Preferir componentes migrables a producción.
- Métricas mínimas: latencia media aceptable, tasa máxima de fallback, tasa máxima de override y coste previsto por volumen.
- Checkpoints: revisión de seguridad de datos, pruebas de prompt a ciegas, auditoría humana inicial y validación de logs de inferencia.
- Criterio de paso: concordancia entre sugerencia de IA y revisión humana por encima del umbral acordado en muestra representativa, sin incidentes de exposición de PII.
Preguntas frecuentes operativas
¿Puede la IA generativa modificar sistemas operativos?
Sí, técnicamente puede. La buena práctica es separar sugerencia y ejecución; exigir autorización explícita siempre que el flujo afecte datos sensibles o transaccionales.
¿Se pueden auditar las respuestas generadas?
Sí, si el sistema registra metadatos esenciales — versión del prompt, contexto referenciado, modelo usado e id del revisor. Evite almacenar datos sensibles en texto plano sin anonimizar.
¿Cómo garantizar privacidad al usar APIs de terceros?
Anonimización previa, minimización de contexto y contratos que limiten retención/uso son medidas básicas. Cuando no sea suficiente, considere hospedar embeddings o inferencia en entorno controlado.
¿Cómo entrenar modelos con datos propietarios de forma segura?
Opciones: entrenamiento interno en entornos controlados, embeddings locales o fine-tuning aislado. Validar riesgos legales y de exfiltración antes de usar terceros.
¿Nivel mínimo de gobernanza para un PoC?
Plantillas de prompts versionadas, entorno de prueba aislado, gate humano para cambios críticos, logging de inferencias y política de anonimización. Con eso puede iterar sin exponer sistemas.
Intercambios y recomendación práctica
El intercambio principal es entre velocidad y control: APIs aceleran el despliegue; on-device protege datos. Un enfoque híbrido — embeddings locales y generación controlada por un orquestador — suele equilibrar coste, privacidad y capacidad de evolución.
Recomendación inicial: empezar con un PoC de asistente en modo sugestión en un flujo no transaccional, con embeddings para mejorar relevancia, prompts versionados, gate humano y observabilidad desde el primer día para medir beneficios operativos con seguridad.
Siguiente paso para ejecutar un piloto seguro
Si desea convertir esta hoja de ruta en un PoC técnico con integración controlada, MVX puede diseñar el flujo, el orquestador de prompts y la capa de observabilidad alineada con sus requisitos de privacidad. Para discutir un piloto y métricas de éxito, contacte a través de nuestras páginas de Automação & IA, APIs & Integraciones o explore Software a medida.