 DIGITAL
Como projetar um app com IA generativa sem perder o controle: arquitetura, limites e governança
Prometer respostas automáticas é fácil; manter controle sobre resultados, custo e compliance no cotidiano do app é o desafio. Este roteiro prático mostra como decidir, projetar e operar recursos de IA em um aplicativo corporativo, com critérios claros para PoC e produção.
Um assistente interno que, por erro, altera campos sensíveis em registros operacionais é a situação que ninguém quer enfrentar numa manhã de segunda-feira. Prometer respostas automáticas é simples; garantir que a IA não introduza inconsistência, custos inesperados ou riscos de compliance é o verdadeiro trabalho. Aqui está a tese que guia este roteiro: IA generativa é utilidade condicional — eficiente em tarefas de assistência, classificação e rascunho, perigosa quando recebe autonomia sobre modificações críticas. A arquitetura, limites operacionais e governança de prompts definem se a IA ajuda ou vira problema.
Quais usos de IA geram ROI operacional e quais evitar
Comece avaliando cenários com impacto mensurável e superfície de risco controlável. Três cenários comuns em apps corporativos ajudam a decidir:
Assistente interno com sugestões (alto benefício, risco moderado)
Descrição: um agente que sugere textos, roteiros de atendimento ou ações, mas exige aprovação humana antes de executar mudanças. Por que funciona: reduz esforço repetitivo e acelera processos. Limite essencial: nenhuma ação automática sobre dados sensíveis sem aprovação.
Enriquecimento de dados e classificação (alto benefício, baixo risco)
Descrição: usar IA para extrair entidades, gerar metadados e classificar registros para melhorar busca e roteamento. Por que funciona: melhora eficiência de busca e analytics sem alterar sistemas transacionais. Limite: validar amostras e manter logs de origem das inferências.
Busca contextual com embeddings (benefício situacional, risco de custo e privacidade)
Descrição: combinar vetores semânticos com um modelo generativo para respostas contextuais. Por que funciona: transforma grandes bases em respostas úteis. Limite: controle sobre dados indexados, direitos de uso e estratégia de atualização dos vetores.
Quando optar por modelos on-device vs APIs na nuvem
A escolha entre local e nuvem é uma decisão arquitetural com trade-offs claros. Use estas regras práticas para decidir.
- On-device (ou on-premises): escolha quando a latência local e a preservação de dados sensíveis são críticas, ou quando políticas de privacidade impedem envio a terceiros. Limite: capacidade de manutenção, necessidade de atualizações de modelos e custo de hardware.
- APIs na nuvem: escolha quando precisa de modelos atualizados, escalabilidade elástica e integração rápida. Limite: exposição de dados aos provedores e custos por chamada; mitigação exige anonimização e contratos adequados.
- Híbrido: embeddings locais com camada de geração na nuvem, ou inferência local para passos determinísticos e API para geração criativa. Esse padrão combina controle e capacidade.
Arquitetura prática: fluxos de dados e padrões de integração
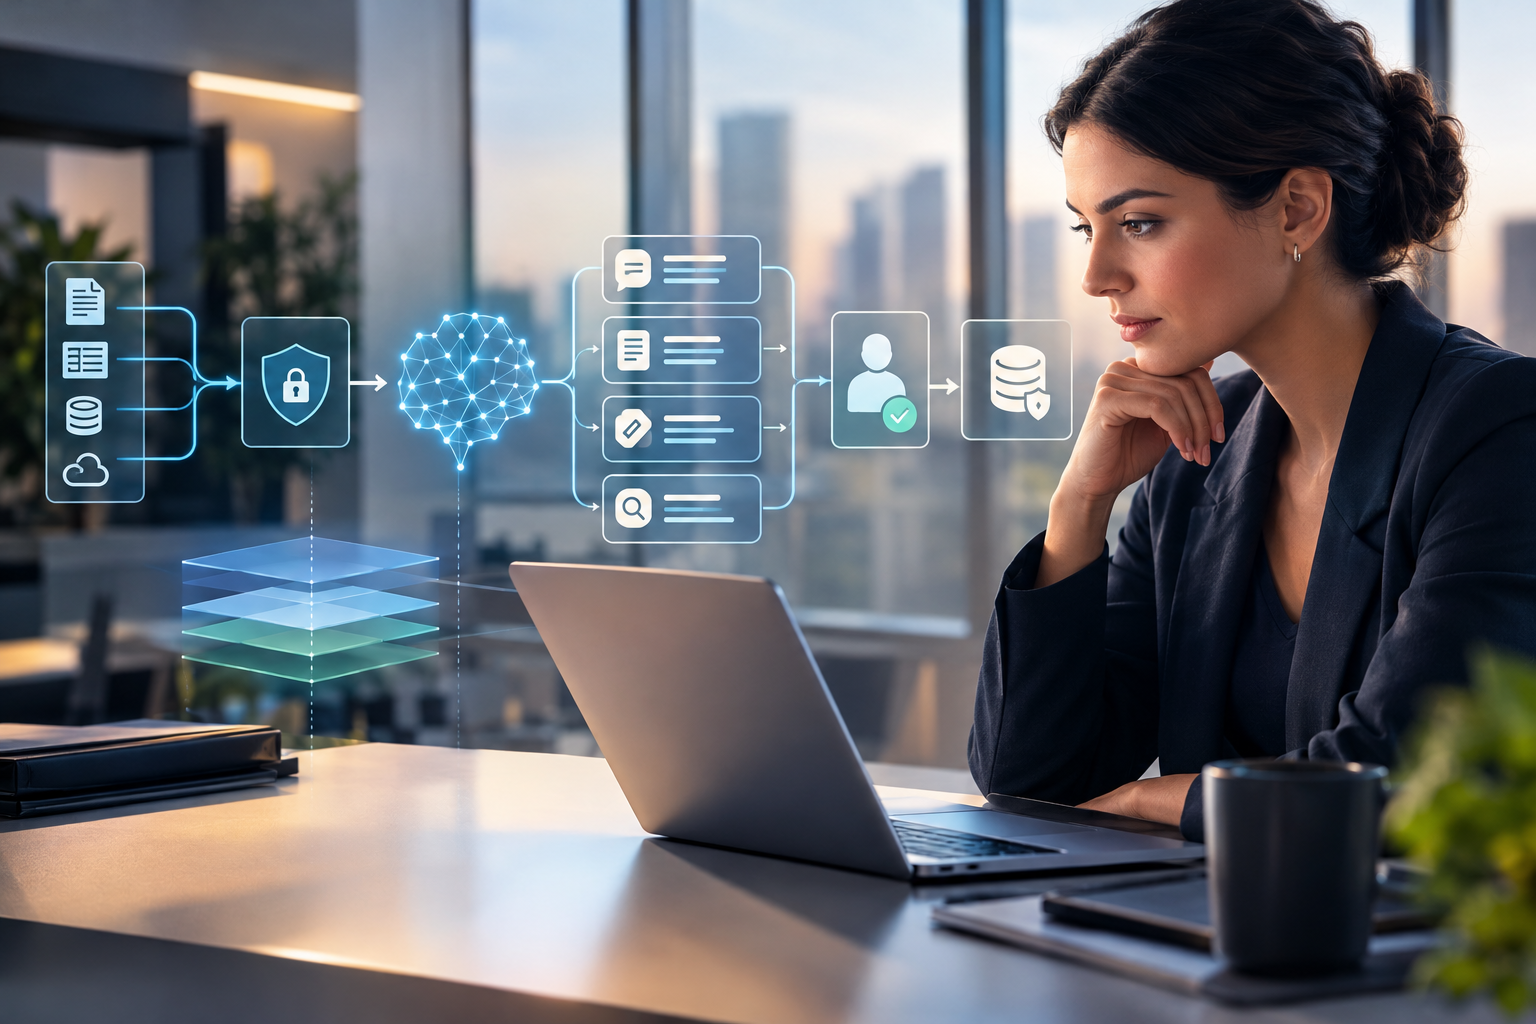
Arquitetura mínima recomendada para um app corporativo que usa IA generativa:
- Ingestão e pré-processamento: normalização e anonimização antes de qualquer envio externo.
- Camada de embeddings e vector DB: feita localmente ou em ambiente controlado para preservar propriedade intelectual; usada para busca contextual.
- Orquestrador de prompts: serviço que aplica templates, limites de tokens e políticas de uso antes de chamar modelos.
- Camada de inferência: pode ser API terceirizada ou motor on-device; responde ao orquestrador e devolve rascunho ou ações sugeridas.
- Validação humana e regras de bloqueio: etapas automatizadas de checagem e aprovação, com logs e possibilidade de rollback.
- Observabilidade e auditoria: captura de métricas e rastros para cada inferência, sem armazenar dados sensíveis indevidamente.
Exemplo de fluxo (ilustrativo): usuário solicita resumo de documento → pré-processamento anonimiza PII → vector DB retorna passagens relevantes → orquestrador monta prompt com limites e contexto → modelo gera rascunho → sistema registra metadados da inferência e apresenta sugestão para revisão humana.
Governança de prompts, testes e aprovação humana
Governança é operacional: não basta ter políticas no papel. Implemente regras acionáveis que equipes de produto podem aplicar:
- Checklist de prompts: templates aprovados, variáveis permitidas e filtros de negatividade. Cada prompt versionado com metadata de autor e data.
- Ambiente de testes controlado: A/B com tráfego reduzido e escopo limitado antes de roll‑out.
- Gate humano por categoria: ações que alteram dados sensíveis exigem aprovação explícita ou um modo somente-sugestão.
- Política de dados: quais campos podem sair do ambiente; quando usar hashing, truncamento ou anonimização.
- Processo de revisão periódica: validação manual de amostras e recalibração de prompts quando erros recorrentes aparecem.
Checklist rápido de governança de prompts
- Existência de templates aprovados e versionados.
- Limites de contexto e tokens definidos.
- Validação humana para alterações críticas.
- Registro de inputs/outputs com metadados para auditoria.
- Procedimento de anonimização antes de envio.
Observabilidade e métricas operacionais essenciais
Defina métricas que permitam decisões claras sem depender de intuições vagas. Priorize:
- Latência por chamada: monitorar distribuições e picos que impactam UX.
- Custo por chamada: calcular impacto financeiro por jornada de usuário.
- Taxa de fallback: porcentagem de vezes em que a IA não atende e aciona rota alternativa ou humano.
- Taxa de override humano: quando revisores alteram a sugestão da IA; indica precisão prática.
- Taxa de geração insegura: eventos onde a saída viola políticas (linguagem inadequada, PII exposto). Deve gerar alertas automáticos.
Instrumente logs com metadados (versão do prompt, origem do contexto, identificador de revisão humana) e retenha apenas o necessário para auditoria, respeitando políticas de privacidade.
Plano de PoC e critérios de sucesso acionáveis
Um PoC eficaz tem escopo reduzido, critérios mensuráveis e limites claros. Estruture assim:
- Objetivo sucinto: ex. reduzir tempo médio de revisão em um fluxo específico sem permitir alterações automáticas nos registros.
- Escopo técnico: fontes de dados, se haverá embeddings locais, qual modelo será orquestrado e se haverá integração com APIs. Preferir componentes que possam ser migrados da PoC para produção.
- Métricas mínimas: latência média aceitável, taxa máxima de fallback, taxa máxima de override humano e custo previsto por volume.
- Checkpoints: revisão de segurança de dados, testes de prompt em amostra cega, auditoria humana inicial e validação de logs de inferência.
- Critério de passagem: concordância entre sugestão da IA e revisão humana acima do limiar acordado em amostra representativa, sem incidentes de exposição de PII.
Perguntas frequentes operacionais
IA generativa pode alterar dados em sistemas operacionais?
Sim, tecnicamente pode. A melhor prática é separar modos: sugerir vs executar. Exigir autorização explícita (atuando como gate) sempre que o fluxo impacta dados sensíveis ou transacionais.
É possível auditar respostas geradas por modelos?
Sim, desde que o sistema registre metadados essenciais de cada inferência — prompt versão, contexto referenciado, modelo usado e identificador de revisão humana. Mas cuidado: não registre dados sensíveis em texto bruto sem anonimização.
Como garantir privacidade ao enviar dados para APIs de terceiros?
Anonimização antes do envio, minimização de contexto e uso de contratos que definam limites de retenção e uso são medidas básicas. Quando isso não for suficiente, considere hospedagem on-premises dos embeddings ou do modelo.
Como treinar modelos com dados proprietários de forma segura?
Opções: treinar modelos internamente em ambientes controlados, usar embeddings locais para manter vetores proprietários, ou adotar técnicas de fine-tuning/adapter em ambientes que garantam isolamento. Sempre valide legalidade e risco de exfiltração antes de usar terceiros.
Qual o nível mínimo de governança para um PoC com IA?
Template de prompt versionado, ambiente de teste isolado, gate humano para mudanças críticas, log de inferências e política clara de anonimização. Esses itens permitem iterar sem expor sistemas ou comprometer compliance.
Trade-offs práticos e recomendação de primeiro experimento técnico
Trade-offs surgem entre controle e velocidade de adoção: APIs em nuvem reduzem tempo de integração; on-device aumenta controle sobre dados. Embeddings locais com geração controlada por orquestrador híbrido é um caminho que equilibra custo, privacidade e capacidade de evolução.
Recomendação prática: iniciar por um PoC focado em assistente de sugestão (modo somente-sugestão) integrado a um fluxo não-transacional, com embeddings para melhorar relevância. Use versãoing de prompts, gate humano e métricas de observabilidade já no primeiro sprint. Isso permite avaliar ganho operacional sem abrir mão do controle.
Próximo passo para quem quer avançar sem risco
Se você quer transformar esse roteiro em um PoC técnico com integração controlada, a MVX ajuda a projetar o fluxo, orquestrador de prompts e a camada de observabilidade alinhada a requisitos de privacidade. Para discutir um piloto e critérios de sucesso, agende um PoC de IA em aplicativo através da nossa página de Automação & IA ou avalie integrações com APIs em APIs & Integrações. Também oferecemos projetos personalizados via Software sob medida.